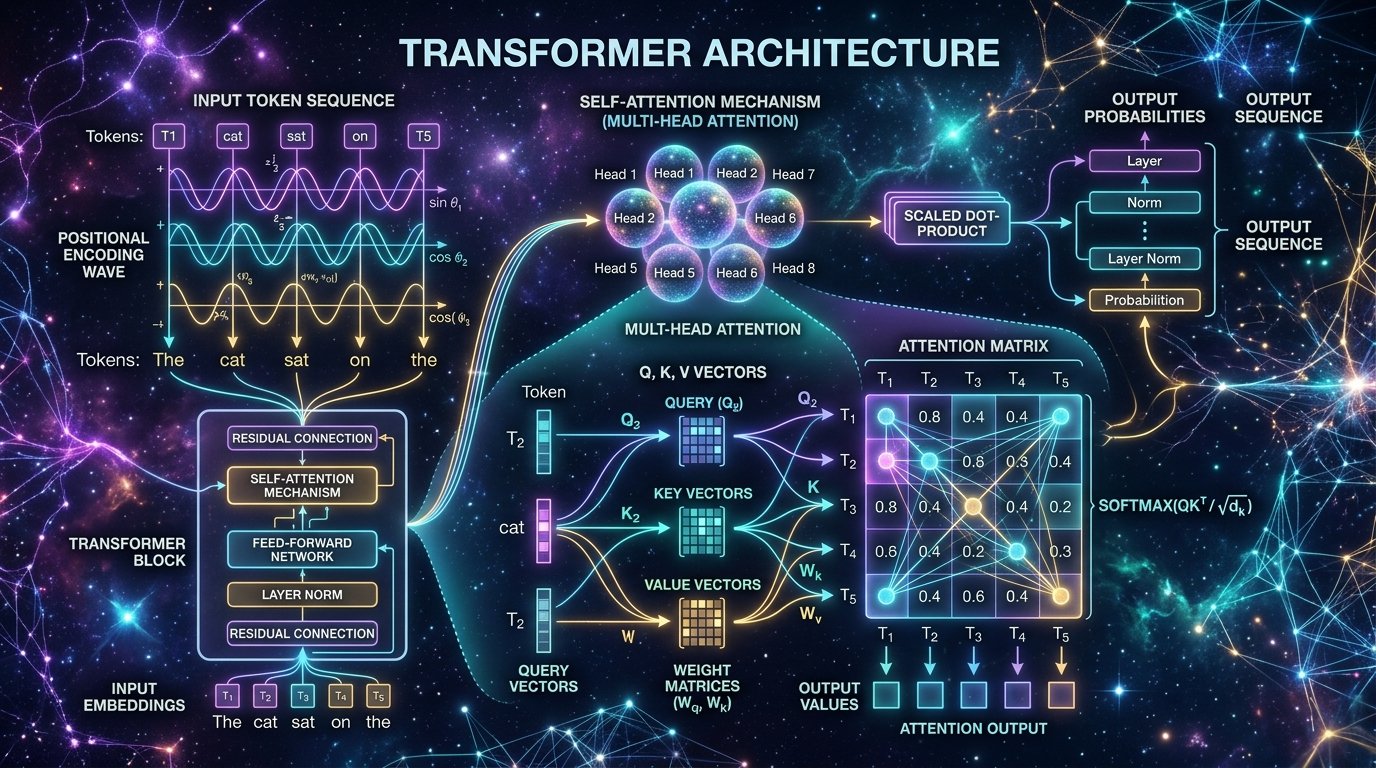
قبل عام 2017، كانت محاولات الذكاء الاصطناعي لفهم اللغات تعتمد على الشبكات العصبية المتكررة (RNNs و LSTMs). كانت تلك الشبكات تقرأ النص كلمة تلو الأخرى بالتتابع الخطي، تماماً مثل شريط تسجيل قديم. فإذا وصلت الشبكة إلى الكلمة المائة في فقرة طويلة، تكون قد نسيت تماماً ما ورد في الكلمة الأولى بسبب مشكلة "تلاشي الانحدار" (Vanishing Gradient).
ثم جاءت الورقة البحثية التاريخية لعلماء جوجل: "الانتباه هو كل ما تحتاجه" (Attention Is All You Need)، لتقلب الموازين وتؤسس معمارية المحولات (Transformers). للمرة الأولى، أصبح بإمكان النموذج معالجة جميع كلمات النص بالتوازي في جزء من الثانية، وحساب الصلة الدلالية بين كل كلمة وجميع الكلمات الأخرى في الجملة.
في هذا المقال التأسيسي العميق لطلاب مقرر فهم الذكاء الاصطناعي: كيف يعمل وكيف يفكّر في منصة INTXA، سنبسط الرياضيات المعقدة لآلية الانتباه الذاتي (Self-Attention) لنكشف كيف تفكر هذه النماذج حقاً.
1. جوهر المشكلة: كيف نفهم معنى الكلمة من سياقها؟#
تأمل كلمة "بنك" في هاتين الجملتين:
1. "جلست على بنك الحديقة أستمتع بنسيم الصباح." (بمعنى مقعد خشبي).
2. "أودعت راتبي الشهري في بنك القاهرة." (بمعنى مؤسسة مصرفية).
قبل المحولات، كان التمثيل الشعاعي الثابت (مثل Word2Vec) يمنح كلمة "بنك" متجهاً رقمياً ثابتاً بغض النظر عن الجملة. أما في شبكات المحولات، فإن المتجه الرقمي للكلمة يتغير ديناميكياً بناءً على الكلمات المحيطة بها عبر آلية الانتباه الذاتي (Self-Attention).
الشبكات المتكررة القديمة (RNNs / LSTMs)
- قراءة خطية كلمة بكلمة مما يجعل التدريب بطيئاً جداً
- نسيان الكلمات البعيدة في النصوص الطويلة
- صعوبة التقاط العلاقات المعقدة بين أطراف الجملة
شبكات المحولات الحديثة (Transformers)
- معالجة متوازية لجميع الكلمات في نفس اللحظة (Massive Parallelism)
- اتصال مباشر بين أي كلمتين في النص بغض النظر عن المسافة بينهما
- بناء تمثيل دلالي فائق الدقة يتغير بتغير السياق المحيط | ثورة الذكاء الاصطناعي
2. تشريح آلية الانتباه: ثالوث الاستعلام والمفتاح والقيمة (Q, K, V)#
لكي تفهم كيف تحسب المحولات الانتباه، تخيل أنك تبحث في محرك يوتيوب:
- الاستعلام (Query - Q): ما تبحث عنه أنت (نص البحث في خانة البحث).
- المفتاح (Key - K): عناوين ومواصفات كل فيديو موجود في قاعدة البيانات.
- القيمة (Value - V): محتوى الفيديو الفعلي الذي ستحصل عليه.
تقوم آلية الانتباه بضرب متجه الاستعلام الخاص بكل كلمة في متجهات المفاتيح لجميع الكلمات الأخرى لحساب "درجة التطابق والصلة"؛ والكلمات التي تحقق أعلى درجة تطابق يتم ترجيح قيمها (Values) بشكل أكبر.
وتُعبر المعادلة الرياضية الشهيرة عن ذلك كالتالي:
$$\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{Q K^T}{\sqrt{d_k}}\right) V$$
حيث:
- $Q K^T$ يمثل الضرب القياسي (Dot Product) لحساب مدى تشابه كل كلمة مع الأخرى.
- $\sqrt{d_k}$ عامل تحجيم لمنع تضخم الأرقام وضمان استقرار حسابات الانحدار.
- $\text{softmax}$ تحويل درجات التشابه إلى نسب مئوية احتمالية مجموعها يساوي 1 (100%).
- الضرب في $V$ لإنتاج المتجه السياقي الجديد المشبع بالمعنى.
3. الانتباه متعدد الرؤوس (Multi-Head Attention)#
لماذا لا نكتفي بآلية انتباه واحدة؟ لأن الجملة الواحدة تحتوي على علاقات لغوية متعددة في نفس الوقت:
- رأس انتباه يفحص العلاقات النحوية (ربط الفعل بالفاعل).
- رأس انتباه يفحص علاقات الضمائر (إلى من يعود الضمير "هو" أو "هي").
- رأس انتباه يفحص العلاقات الزمنية والمكانية.
عبر تقسيم الأوزان إلى رؤوس متعددة (Multi-Head)، يستطيع المحول النظر إلى النص من زوايا لغوية ومنطقية متباينة في آن واحد، ثم دمج هذه الرؤى في تمثيل معرفي شامل.
التشفير الموضعي (Positional Encoding)
بما أن المحول يقرأ كل الكلمات بالتوازي، فإنه يحتاج إلى موجات جيبية (Sine & Cosine Waves) تضاف إلى متجهات الكلمات ليعرف ترتيب وموقع كل كلمة في الجملة.
الاتصالات المتبقية (Residual Connections)
تمرير نسخة من المدخل الأصلي عبر مسار جانبي وتجاوز الطبقة العصبية لجمعه مع المخرج، مما يمنع ضياع الإشارات التأسيسية أثناء التدريب العميق.
التسوية الطبقية (Layer Normalization)
إعادة ضبط وتطبيع التوزيع الإحصائي للأوزان داخل كل طبقة للحفاظ على استقرار الحسابات وسرعة تدريب النموذج.
شبكة التغذية الأمامية (Feed-Forward Network)
طبقة عصبية كثيفة تعالج كل توكن بشكل مستقل لتعميق تمثيله المفاهيمي وتخزين المعارف العامة التي اكتسبها النموذج.
4. مسار معالجة التوكن داخل شبكة المحول (Step-by-Step)#
التقطيع والترميز (Tokenization & Embedding)
تقسيم النص العربي إلى توكنز وتحويل كل توكن إلى متجه رقمي عالي الأبعاد (مثلاً 4096 بعداً في النماذج الكبيرة).
دمج الموقع والترتيب (Add Positional Encoding)
إضافة إشارة الترتيب المكاني لكل كلمة ليعلم النموذج أن "أحمد زار محمد" تختلف تماماً عن "محمد زار أحمد".
حساب الانتباه الذاتي متعدد الرؤوس (Multi-Head Self-Attention)
تتفاعل جميع الكلمات معاً، وتحسب كل كلمة أوزان انتباهها مع بقية الكلمات المرافقة لامتصاص المعنى السياقي.
المعالجة العميقة والتسوية (Add & Norm + FFN)
تمرير المخرجات عبر الاتصالات المتبقية وشبكات التغذية الأمامية لتعميق الاستدلال وتثبيت الأوزان.
توليد التوكن التالي (Output Probabilities)
حساب التوزيع الاحتمالي لكافة الكلمات في القاموس، واختيار الكلمة التالية الأكثر منطقية واتساقاً مع السياق.
5. اختبار تحصيلي في فهم المحولات#
اختبر فهمك
في معادلة الانتباه الذاتي $\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{Q K^T}{\sqrt{d_k}}\right) V$، ما هي الفائدة الرياضية من القسمة على $\sqrt{d_k}$؟
شرح: عندما تكون أبعاد المتجهات كبيرة (مثل 128 أو 256)، يكبر ناتج الضرب القياسي بشدة، مما يجعل مخرجات softmax قريبة جداً من 0 أو 1، فيتوقف تدريب النموذج؛ والقسمة على جذر البعد تعيد القيم لنطاقها الإحصائي المستقر.
أسئلة شائعة (FAQ)#
ما هو الفرق بين محولات التشفير (Encoder-Only) ومحولات فك التشفير (Decoder-Only)؟#
نماذج الـ Encoder (مثل BERT) تقرأ النص ثنائي الاتجاه بالكامل وهي ممتازة لتصنيف النصوص واستخراج البيانات والبحث الدلالي. أما نماذج الـ Decoder (مثل عائلة GPT و LLaMA) فتستخدم قناع انتباه (Causal Masking) يمنع الكلمة من النظر لما بعدها، وهي المصممة أصلاً لتوليد النصوص كلمة بكلمة.
هل تفهم نماذج المحولات اللغة العربية بنفس كفاءة اللغة الإنجليزية؟#
تعتمد كفاءة النموذج على جودة وكثافة الـ Tokens العربية في مرحلة بناء الـ Tokenizer وتوازن بيانات التدريب؛ ونماذج الجيل الحديث تظهر فهماً استثنائياً للبلاغة والنحو العربي عند تدريبها على مجموعات بيانات منقاة وموزونة.
ما هي التطورات القادمة التي تتجاوز معمارية Transformers الكلاسيكية؟#
تظهر اليوم معماريات هجينة واعدة تجمع بين المحولات ونماذج الحالة الفضائية (State Space Models) مثل Mamba، والتي تهدف لمعالجة سياقات غير محدودة باستهلاك خطي للذاكرة بدلاً من الاستهلاك التربيعي ($O(N^2)$) الكلاسيكي لآليات الانتباه.