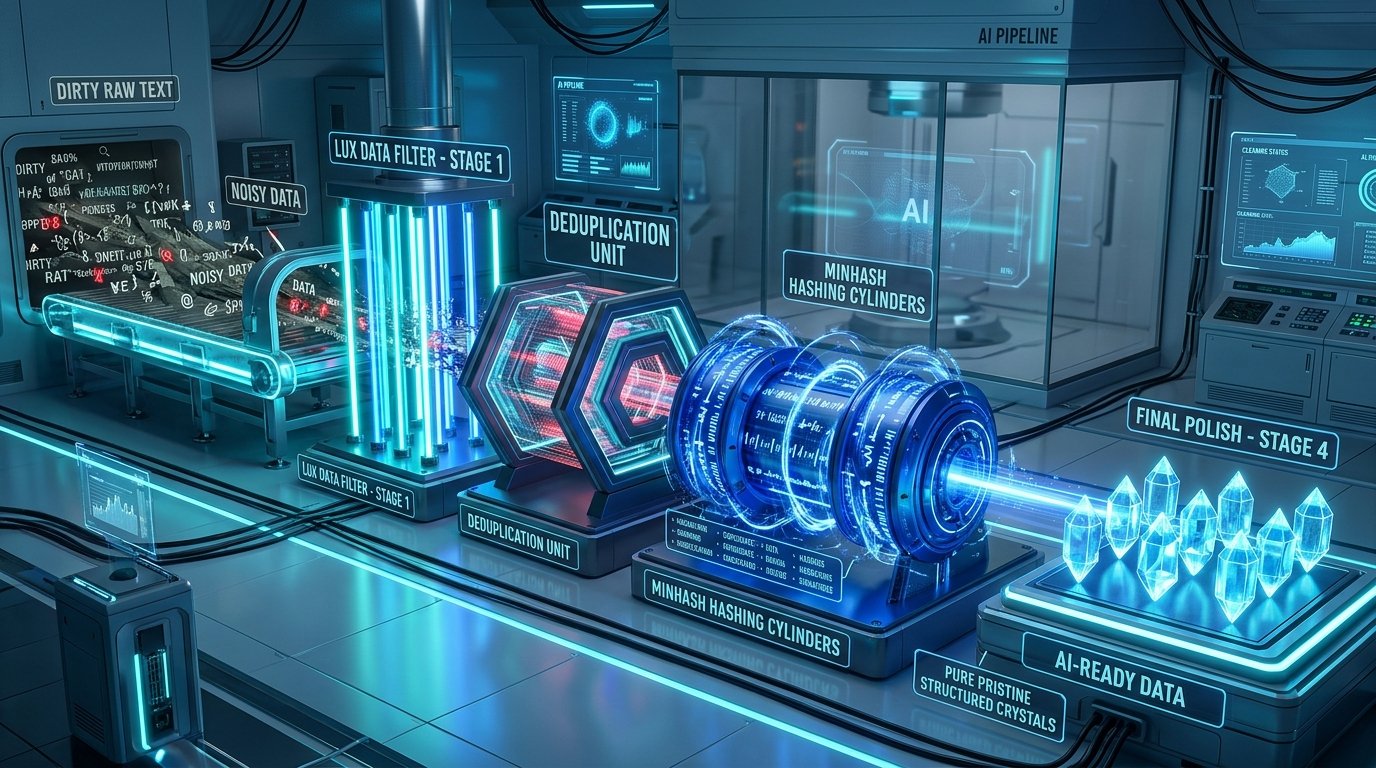
القاعدة الأزلية في علوم البيانات وهندسة الذكاء الاصطناعي لم تتغير: "المدخلات الرديئة تنتج مخرجات رديئة" (Garbage In, Garbage Out). في عصر النماذج اللغوية الكبيرة (LLMs)، أثبتت التجارب أن تدريب نموذج على 10 مليارات توكن من البيانات فائقة النقاء ينتج ذكاءً واستدلالاً يفوق بكثير تدريبه على 100 مليار توكن ممتلئة بالصفحات المكررة، والضوضاء البرمجية، والمحتوى الترويجي الرديء.
في هذا المقال المتعمق الموجه لطلاب مقرر تنظيف البيانات لتدريب النماذج في منصة INTXA، سنستعرض المعمارية العملية لبناء خط أنابيب تنظيف بيانات متكامل قادر على معالجة ملايين النصوص بكفاءة وسرعة.
1. تشريح الشوائب: ماذا يوجد داخل البيانات الخام المجمعة من الويب؟#
عند كشط ملايين الصفحات من الإنترنت لبناء مجموعة تدريب، تحتوي البيانات الخام على تشوهات تدمر قدرات النموذج:
- التكرارات الوبائية (Near-Duplicates): آلاف النسخ المكررة من شروط الخدمة، وإشعارات ملفات تعريف الارتباط (Cookie Banners)، والبيانات الصحفية المعاد نشرها.
- الضوضاء الصرفة (Machine Noise): بقايا وسوم HTML وJavaScript وشفرات CSS ورموز الرموز التعبيرية المشوهة (Mojibake).
- البيانات الشخصية الحساسة (PII): أرقام الهواتف، العناوين البريدية، وأرقام بطاقات الائتمان التي تعرض النموذج لمساءلات قانونية وأمنية.
- المحتوى منخفض الجودة (Low-Quality SEO Content): مقالات حشو مكررة أُنشئت بهدف التلاعب بمحركات البحث دون أي قيمة معرفية حقيقية.
بيانات التدريب الخام غير المعالجة
- تكرار نفس النصوص آلاف المرات مما يؤدي لـ Memorization وتكرار النموذج للكلام
- وجود أرقام هواتف وبيانات سرية حقيقية تتسرب في المحادثات
- صعوبة استقرار التدريب وتذبذب دالة الخسارة (Loss Spikes)
مجموعة البيانات المنقاة والمعايرة
- إزالة التكرار التقريبي بدقة فائقة عبر خوارزمية MinHash LSH
- إخفاء وتشفير كافة المعلومات الشخصية والبيانات الحساسة
- توزيع متوازن للمفردات يضمن استدلالاً عميقاً وأداءً لغوياً متفوقاً | بيانات تدريب نقية
2. خوارزمية MinHash LSH: كيف تكتشف التكرار بين ملايين النصوص؟#
إذا كان لديك مليون مستند، فإن مقارنة كل مستند بالآخرين تتطلب تريليون عملية مقارنة، وهو أمر مستحيل عملياً. هنا تبرز عبقرية خوارزمية MinHash مع Locality Sensitive Hashing (LSH):
- التقطيع (Shingling): تحويل النص إلى مجموعات من الكلمات المتتالية (n-grams)، مثل سلاسل ثلاثية من الكلمات.
- التجزئة المصغرة (MinHashing): تحويل كل مجموعة إلى بصمة رقمية صغيرة ثابتة الطول (Signature) تحافظ إحصائياً على معامل تشابه جاكارد (Jaccard Similarity).
- التجميع الحساس للموضع (LSH): تقسيم البصمات إلى مجموعات؛ فإذا تشابهت مستندات في مجموعة واحدة، يتم اعتبارها مرشحة للتطابق وفحصها فورياً، مما يقلل العمليات الحسابية بنسبة 99.9%.
3. خط أنابيب التنظيف الهندسي خطوة بخطوة#
الاستخلاص والتوحيد البنيوي (Text Extraction & Normalization)
استخلاص النص النقي وتوحيد المحارف؛ مثل إزالة التشكيل غير الضروري، وتوحيد المسافات البيضاء، وتوحيد ترميز الـ Unicode لضمان اتساق تمثيل الحروف في نموذج التقطيع (Tokenizer).
التصفية الاستكشافية القائمة على القواعد (Heuristic Quality Filters)
حذف أي نص يقل طوله عن 50 كلمة، أو تزيد فيه نسبة الأرقام والرموز الخاصة عن 30%، أو تظهر فيه الكلمات المكررة بشكل شاذ (مثل تكرار نفس الكلمة 5 مرات متتالية).
تصنيف اللغة واكتشاف جودة النص (Language Identification & Perplexity)
استخدام نماذج تصنيف لغوي سريعة (مثل FastText) للتأكد من هوية اللغة، واستبعاد النصوص المترجمة آلياً برداءة عبر حساب معامل الارتباك (Perplexity) مقارنة بمرجع لغوي فصيح.
إزالة التكرار الشامل (Deduplication via MinHash)
تشغيل خط MinHash لحذف الصفحات والمقاطع المتطابقة دلالياً بنسبة تزيد عن 80%، والاحتفاظ بنسخة واحدة فقط تمثل النص الأصلي.
تطهير البيانات الحساسة (PII Scrubbing & Anonymization)
تطبيق تعبيرات نمطية (Regex) ونماذج التعرف على الكيانات المسماة (NER) لاستبدال الأسماء الصريحة وأرقام الهواتف والبطاقات بوسوم عامة مثل
[PHONE_NUMBER]و[EMAIL_ADDRESS].
4. نموذج بايثون لتطهير البيانات الحساسة (PII Redaction)#
import re

def sanitize_dataset_text(text: str) -> str:
    # 1. إخفاء البريد الإلكتروني
    email_pattern = r'[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+'
    text = re.sub(email_pattern, "[EMAIL]", text)

    # 2. إخفاء أرقام الهواتف الدولية والمحلية
    phone_pattern = r'(\+?\d{1,3}[-.\s]?)?\(?\d{3}\)?[-.\s]?\d{3}[-.\s]?\d{4}'
    text = re.sub(phone_pattern, "[PHONE]", text)

    # 3. إخفاء أرقام بطاقات الائتمان (16 رقماً)
    cc_pattern = r'\b(?:\d{4}[-\s]?){3}\d{4}\b'
    text = re.sub(cc_pattern, "[CARD_NUMBER]", text)

    # 4. إزالة وسوم HTML المتبقية
    text = re.sub(r'<[^>]+>', ' ', text)

return re.sub(r'\s+', ' ', text).strip()5. اختبار تحصيلي في هندسة البيانات#
اختبر فهمك
لماذا نقوم بإزالة التكرارات التقريبية (Deduplication) من بيانات تدريب النماذج اللغوية بدلاً من تركها لزيادة حجم البيانات؟
شرح: أظهرت الأبحاث الأكاديمية (مثل أبحاث ديب مايند وستانفورد) أن التكرار في بيانات التدريب يدفع النموذج للتحيز الشديد للعبارات المكررة ويفقده القدرة على التعميم الاستدلالي.
أسئلة شائعة (FAQ)#
ما هي الصيغة المثالية لحفظ مجموعات البيانات المنظفة لأغراض التدريب؟#
الصيغة الأكثر كفاءة هي Apache Parquet أو JSONLines (JSONL) المضغوط بـ Zstandard. تتيح هذه الصيغ قراءة سريعة متوازية (Streaming Dataset Loading) عبر مكتبات Hugging Face Datasets و PyTorch دون استهلاك كامل الذاكرة العشوائية للخادم.
هل يكفي استخدام التعبيرات النمطية (Regex) لتطهير جميع البيانات الحساسة (PII)؟#
التعبيرات النمطية ممتازة للأنماط الثابتة كأرقام الهواتف والبطاقات والبريد، ولكن للأسماء الشخصية، وأسماء الشركات، والعناوين غير النمطية، يُفضل دمج الـ Regex مع نموذج تعرف على الكيانات المسماة (NER) مثل GLiNER أو SpaCy لتحقيق أعلى تغطية أمنية.
ما هو الفرق بين تنظيف البيانات للتدريب المسبق (Pre-training) وتنظيفها للضبط الدقيق (Fine-Tuning)؟#
بيانات التدريب المسبق تتطلب معالجة ضخمة بمقاييس التيرابايت والتركيز على التصفية الإحصائية وإزالة التكرار، بينما بيانات الضبط الدقيق (Instruction Fine-Tuning) تعتمد على جودة الصياغة الحوارية، وتماسك السؤال والجواب، والتنوع المعرفي العالي لكل عينة على حدة.