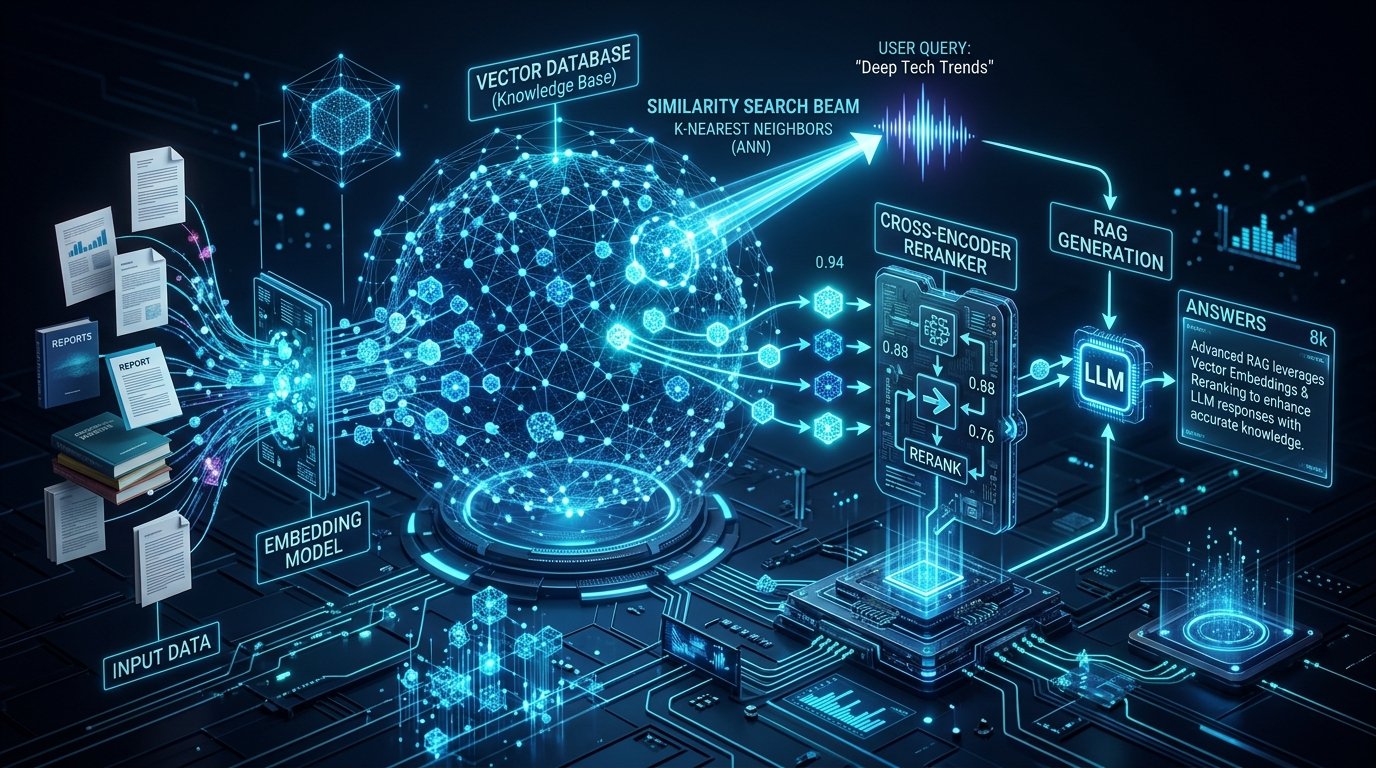
تواجه معظم الفرق الهندسية صدمة غير سارة عند محاولة نقل نظام التوليد المعزز بالاسترجاع (RAG) من مرحلة النموذج الأولي الممتع إلى بيئة الإنتاج المؤسسية الصارمة. في العروض التوضيحية البسيطة (Naive RAG)، يعمل تقطيع المستندات بطول 500 حرف وحساب تشابه جيب التمام (Cosine Similarity) عبر قاعدة بيانات شعاعية بشكل مقبول، لكن عند الاصطدام بمستندات مالية، أو عقود قانونية معقدة، أو استفسارات دقيقة باللغة العربية، يسقط النظام فوراً في فخين قاتلين: استرجاع مقاطع غير ذات صلة ولكنها تشبه السؤال لغوياً، أو اقتطاع الإجابة الدقيقة عند حدود الفواصل العشوائية للمقاطع.
في هذا الدليل العملي لطلاب مقرر إعداد ملفات المعرفة وأنظمة RAG في INTXA، نستعرض معمارية الـ Advanced RAG التي تعتمدها كبرى الأنظمة العالمية لضمان دقة معلوماتية تقارب 100%.
1. لماذا يسقط الـ RAG التقليدي (Naive RAG) في الإنتاج؟#
الـ RAG البسيط يعتمد على افتراض ساذج: أن أفضل المقاطع إجابة عن السؤال هي المقاطع الأكثر شبهاً بكلمات السؤال دلالياً. هذا الافتراض خاطئ للأسباب التالية:
- انقطاع السياق (Context Fragmentation): تقسيم ملف PDF إلى كتل ثابتة (500 توكن مثلاً) قد يفصل الفقرة عن جدول البيانات المرفق معها، فيفقد النموذج معنى الأرقام.
- عمى المصطلحات التقنية والرموز (Keyword Blindness): النماذج الشعاعية (Dense Embeddings) تفهم المفاهيم العامة لكنها غالباً ما تخلط بين أرقام الموديلات الدقيقة (مثل كود الخطأ
ERR-4029أو رقم المادة القانونيةالمادة 12/ب). - انخفاض الكثافة المعلوماتية: استرجاع 5 مقاطع طويلة يملأ نافذة السياق بحشو كلامي غير مفيد، مما يشتت انتباه النموذج اللغوي (Lost in the Middle Phenomenon).
الـ RAG التقليدي السطحي (Naive RAG)
- تقطيع نصوص ثابت الحجم (Fixed-size Chunking)
- بحث شعاعي نقي فقط (Dense Vector Search Only)
- تمرير أعلى 5 نتائج للنموذج دون فرز نوعي
- هلوسة متكررة عند غياب المعلومة المباشرة
الـ RAG المتقدم الهندسي (Advanced RAG)
- تقطيع سياقي هرمي (Hierarchical / Semantic Chunking)
- بحث هجين (Hybrid Search = BM25 + Dense Vectors)
- مرحلة إعادة ترتيب ثانوية بنموذج متقاطع (Cross-Encoder Reranker)
- إسناد دقيق للمراجع وتوليد إجابات موثقة بالفقرة والصفحة | دقة مؤسسية
2. استراتيجيات التقطيع المتقدمة (Advanced Chunking)#
التقطيع الدلالي (Semantic Chunking)
مراقبة التغير المفاجئ في المسافة الشعاعية بين الجمل المتتالية؛ عندما يقفز الموضوع إلى محور جديد، يتم وضع حد الفاصل تلقائياً، مما يحافظ على تكامل المعنى داخل كل كتلة.
نافذة الجملة (Sentence-Window Retrieval)
تخزين وتضمين جملة واحدة دقيقة للبحث الشعاعي، ولكن عند استرجاعها، يتم جلب الجمل السابقة واللاحقة لها المحيطة بها لتقديم سياق كامل ومفهوم للنموذج التوليدي.
استرجاع الوثيقة الأم (Parent-Document Retrieval)
تقسيم النص إلى مقاطع صغيرة جداً (100 توكن) لأغراض الفهرسة والبحث عالي الدقة، وتخزين معرف يشير إلى المستند الأم الأكبر (1000 توكن) ليتم تمريره للنموذج عند التطابق.
التقطيع المتأخر (Late Chunking)
تمرير المستند الطويل بأكمله أولاً عبر طبقات النموذج التضميني لحساب الانتباه المشترك، ثم تجزئة التضمينات لاحقاً، مما يحفظ سياق الوثيقة الكاملة داخل كل مقطع فردي.
3. خط أنابيب استرجاع المعرفة المتقدم خطوة بخطوة#
لتحقيق أقصى درجات الدقة في نظام RAG، اتبع المراحل الهندسية الخمس التالية:
الاستيعاب والتنظيف الذكي (Ingestion & Metadata Enrichment)
تحويل ملفات الـ PDF وجداول البيانات إلى نصوص منظمة بصيغة Markdown، مع استخراج وإرفاق بيانات وصفية غنية (Metadata) تشمل: عنوان المستند، رقم القسم، تاريخ التحديث، ومستوى سرية الوثيقة.
الفهرسة المزدوجة للبحث الهجين (Hybrid Search Indexing)
فهرسة المقاطع في مسارين متوازيين: مسار للأشعة الدلالية (Dense Embeddings) للبحث بالمعنى، ومسار للفهرس العكسي (BM25 Sparse Index) للبحث عن الكلمات المفتاحية والأرقام والمصطلحات الصرفة.
استرجاع الأفق الواسع (Broad Retrieval Stage)
عند طرح المستخدم لسؤال، يتم جلب أعلى 25 إلى 50 مقطعاً من محركي البحث (الشعاعي واللفظي) ودمجها عبر خوارزمية الترتيب التبادلي (Reciprocal Rank Fusion - RRF).
التصفية وإعادة الترتيب (Cross-Encoder Reranking)
تمرير النتائج الخمسين إلى نموذج إعادة ترتيب متخصص (مثل Cohere Rerank أو BGE-Reranker). يحسب النموذج التفاعل المشترك المباشر بين السؤال وكل مقطع ويمنح كل مقطع درجة ملائمة دقيقة من 0 إلى 1.
اختيار النخبة وضبط السياق (Top-K Context Synthesis)
اختيار أعلى 3 إلى 5 مقاطع فقط التي تجاوزت درجة ثقة معينة (مثل > 0.75)، وتنسيقها داخل قالب الأمر مع تعليمات صارمة بالاستشهاد بمصادرها حصراً.
4. نموذج عملي لكود البحث الهجين وإعادة الترتيب#
فيما يلي كود بايثون مبسط يوضح كيفية دمج البحث واستدعاء الـ Reranker:
from sentence_transformers import CrossEncoder

# 1. تهيئة نموذج إعادة الترتيب المتقاطع
reranker = CrossEncoder("BAAI/bge-reranker-large")

def advanced_rag_pipeline(query: str, vector_store, top_k_final: int = 3):
    # 2. استرجاع أفق عريض من المقاطع (مثلاً 20 مقطعاً بالبحث الهجين)
    candidates = vector_store.hybrid_search(query, k=20)

    # 3. إعداد أزواج (السؤال، نص المقطع) لنموذج الـ Cross-Encoder
    pairs = [[query, doc.page_content] for doc in candidates]
    scores = reranker.predict(pairs)

    # 4. دمج المقاطع مع درجات التقييم وترتيبها تنازلياً
    scored_docs = sorted(zip(candidates, scores), key=lambda x: x[1], reverse=True)

    # 5. اختيار أفضل النتائج المطابقة لمعيار الثقة
    final_context = [doc for doc, score in scored_docs[:top_k_final] if score > 0.60]
return final_context5. اختبار تحصيلي في معمارية RAG#
اختبر فهمك
لماذا يُعتبر نموذج إعادة الترتيب المتقاطع (Cross-Encoder) أكثر دقة في تقييم تطابق المقطع مع السؤال مقارنة بتشابه جيب التمام لنماذج التضمين (Bi-Encoder)؟
شرح: نماذج الـ Bi-Encoder تضغط النص الطويل في متجه واحد مما يفقد بعض التفاصيل الدقيقة، بينما الـ Cross-Encoder يمرر السؤال والمقطع معاً في نفس طبقات المحول ليرى كيف تتفاعل مفردات السؤال مباشرة مع محتوى المقطع.
أسئلة شائعة (FAQ)#
كيف أتعامل مع الجداول المدمجة داخل ملفات PDF في أنظمة RAG؟#
أفضل ممارسة هي استخراج الجداول ككتل Markdown أو HTML منفصلة مع تلخيص نصي موجز يوضح محتواها وأهم مؤشراتها في البيانات الوصفية (Metadata)، وتجنب تقطيع الجدول عبر أعمدته أو صفوفه.
متى نفضل البحث الهجين (Hybrid Search) على البحث الشعاعي البحت؟#
في كل تطبيق يتعامل مع أسماء منتجات، أو أرقام موديلات، أو بنود قانونية، أو اختصارات طبية وتقنية؛ حيث يفشل البحث الشعاعي في التمييز بين الأكواد المتقاربة شكلياً، بينما يبرز محرك البحث النصي (BM25) في التقاط هذه الرموز الحرفية فوراً.
كيف نقيس جودة نظام الـ RAG تلقائياً قبل إطلاقه للعملاء؟#
نستخدم أطر تقييم آلية معتمدة مثل Ragas أو TruLens، والتي تقيس 3 مؤشرات محورية: أمانة الإجابة للمصدر (Faithfulness)، وملاءمة الإجابة للسؤال (Answer Relevance)، ودقة استرجاع السياق المفيد (Context Precision).