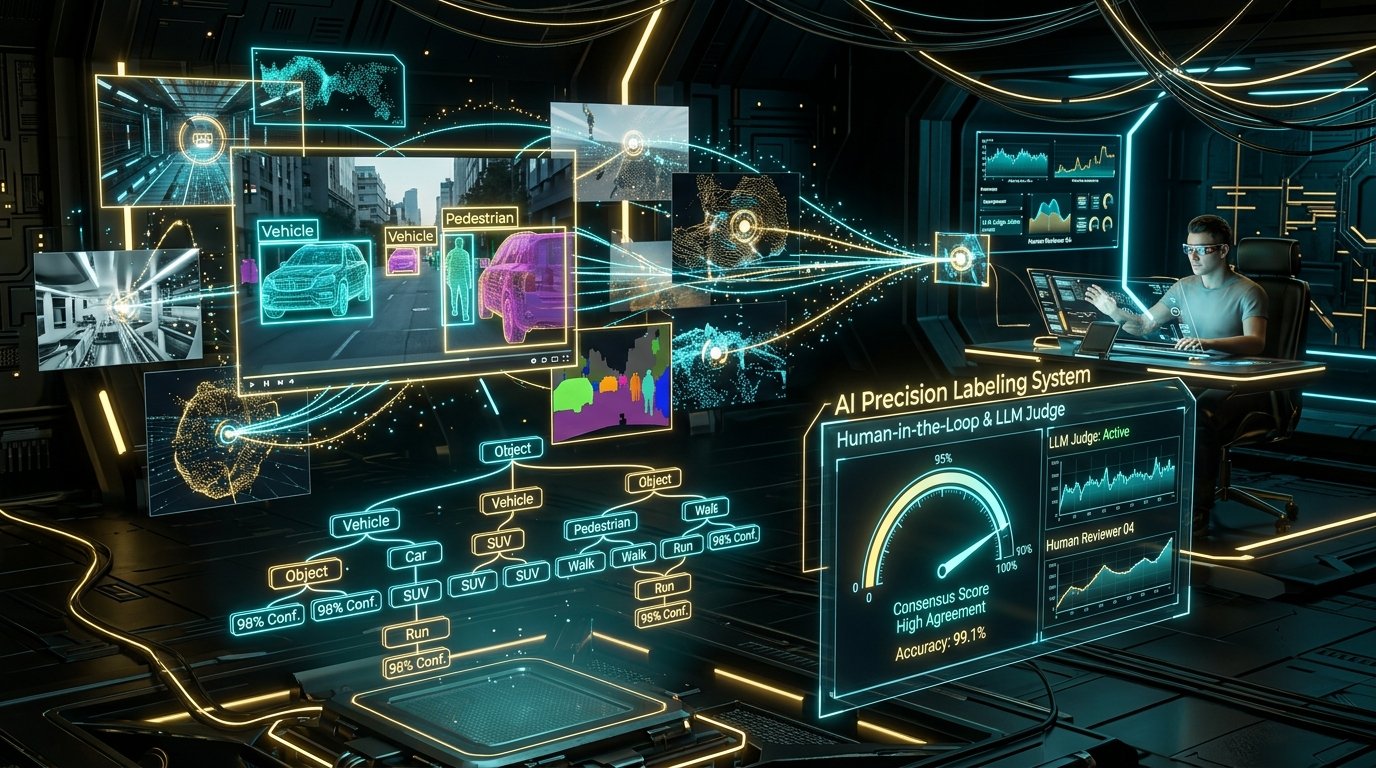
عندما نتحدث عن النجاح المبهر لنماذج المحادثة المتقدمة وضبط سلوكها (Alignment)، فإن السر الحقيقي لا يكمن في مجرد زيادة عدد المعاملات (Parameters)، بل في جودة وتناسق بيانات الحقيقة المرجعية (Ground Truth) التي تم تدريب النموذج عليها في مرحلتي الضبط التوجيهي (SFT) والتعلم المعزز بالتغذية الراجعة البشرية (RLHF / DPO).
إن تصنيف وتوسيم البيانات ليس مجرد عمل روتيني يمارسه هواة، بل هو انضباط منهجي دقيق يتطلب صياغة مواصفات إرشادية صارمة، وحساب مقاييس إحصائية دقيقة لاتفاق المقيّمين، وإدارة مسارات التحكيم عند اختلاف الآراء. في هذا الدليل العملي لطلاب مقرر تصنيف البيانات لتدريب النماذج في منصة INTXA، نستعرض الأصول العلمية والعملية لإدارة مشاريع التوسيم بنجاح.
1. تشريح إرشادات التوسيم: لماذا يختلف المقيّمون البشريون؟#
المشكلة الكبرى في مشاريع التوسيم هي الغموض الدلالي (Ambiguity). إذا طلبت من ثلاثة مراجعين تصنيف جملة: "الخدمة مقبولة لكن السعر مرتفع" إلى (إيجابي / سلبي / محايد)، فقد يختار الأول "سلبي" لتركيزه على السعر، ويختار الثاني "إيجابي" لتركيزه على جودة الخدمة، ويختار الثالث "محايد".
إذا دخلت هذه التناقضات إلى مجموعة بيانات التدريب، فسيتعلم النموذج التردد والارتباك. دور مهندس البيانات هو كتابة دليل التوسيم (Annotation Guidelines) الذي يقضي على أي اجتهاد شخصي عبر قواعد قطعية وأمثلة حافة (Edge Cases).
إرشادات التوسيم السطحية
- «قم بتصنيف تقييمات العملاء إلى إيجابي وسلبي ومحايد بناءً على انطباعك العام.»
- عدم وجود تعريف واضح للعبارات المزدوجة أو التهكم والسخرية
- تشتت تصنيفات المراجعين وانخفاض نسبة الاتفاق إلى أقل من 60%
إرشادات التوسيم الهندسية الصارمة
- شجرة قرار منطقية تفصل بين تقييم الميزات وسعر المنتج
- معايير واضحة لكيفية التعامل مع اللهجات والتهكم (Sarcasm)
- أمثلة قبل وبعد تغطي كافة الحالات الرمادية والملتبسة | بيانات تدريب متسقة
2. القياس الإحصائي لجودة التوسيم: مقياس كابا (Cohen's Kappa)#
لا يكفي قياس نسبة الاتفاق البسيطة (Percent Agreement)، لأن المراجعين قد يتفقون بالصدفة البحتة! المقياس الرياضي المعتمد عالمياً لقياس توافق المقيمين هو Cohen's Kappa ($\kappa$)، وتُحسب معادلته كالتالي:
$$\kappa = \frac{P_o - P_e}{1 - P_e}$$
حيث:
- $P_o$ هي نسبة الاتفاق الملاحظة فعلياً بين المراجعين.
- $P_e$ هي نسبة الاتفاق المتوقعة بالصدفة الإحصائية البحتة.
| قيمة كابا ($\kappa$) | مستوى الاتفاق والتناسق | القرار الهندسي |
|---|---|---|
| أقل من 0.40 | ضعيف جداً (Poor) | رفض البيانات وإعادة كتابة الإرشادات بالكامل |
| 0.41 - 0.60 | معتدل (Moderate) | تعديل إرشادات الحالات الملتبسة وإعادة تدريب المراجعين |
| 0.61 - 0.80 | جوهري ومطمئن (Substantial) | مقبول لمعظم التطبيقات والتدريب التوجيهي العام |
| 0.81 - 1.00 | شبه تام (Near Perfect) | المعيار الذهبي المعتمد للبيانات الطبية والقانونية والمالية |
3. خطة العمل المنهجية لمشروع تصنيف البيانات (Step-by-Step)#
صياغة دليل التصنيف وحصر التصنيفات (Taxonomy Definition)
تحديد شجرة التصنيفات المعتمدة (Classes) بوضوح، مع اشتراط أن تكون الفئات مانعة للجمع وشاملة (MECE: Mutually Exclusive, Collectively Exhaustive) لتجنب تداخل التصنيفات.
تجهيز العينات الذهبية للاختبار (Gold Standard / Honeypots)
إعداد مجموعة من 100 عينة تم فحصها واعتمادها بنسبة 100% من قبل كبار الخبراء. يتم دس هذه العينات بشكل عشوائي داخل مهام المراجعين لمراقبة دقة كل مقيّم آلياً دون علمه.
التوسيم التجريبي وحساب الاتفاق الأولي (Pilot Annotation Phase)
توزيع عينة تجريبية على المراجعين وحساب معامل كابا. عقد جلسة مواءمة لتفكيك نقاط الخلاف وتحديث الدليل الإرشادي بناءً على الأسئلة المستجدة.
خط التوسيم المزدوج والتحكيم (Double-Blind Labeling & Adjudication)
في المهام الحساسة، تُعرض كل عينة على مراجعين اثنين بشكل مستقل. إذا اتفقا يتم اعتماد التصنيف فوراً؛ وإذا اختلفا تُحال العينة تلقائياً إلى خبير أول (Senior Adjudicator) للبت فيها.
التدقيق النهائي والتحويل للصيغ القياسية (QA & Export)
فحص التوزيع النهائي للتصنيفات لضمان التوازن بين الفئات (Class Balance)، وتصدير البيانات بصيغة JSONL مهيكلة ومجهزة لمسارات التدريب.
4. نموذج هيكلي لبيانات التوسيم بصيغة JSONL للضبط الدقيق (SFT)#
{
  "id": "sample-8491",
  "instruction": "حلل الشكوى التالية وحدد سبب المشكلة وقسم المعالجة المسؤول ومستوى الإلحاح.",
  "input": "طلبت استرجاع المبلغ لحسابي البنكي منذ 10 أيام ولم يصلني أي إشعار، ورصيد بطاقتي معلق حتى الآن!",
  "output": {
    "issue_category": "REFUND_DELAY",
    "responsible_department": "FINANCE_OPERATIONS",
    "urgency_level": "HIGH",
    "requires_human_escalation": true
  },
  "annotator_id": "reviewer_04",
  "review_status": "APPROVED",
  "confidence_score": 1.0
}5. اختبار تحصيلي في هندسة توسيم البيانات#
اختبر فهمك
ما هي الفائدة الأساسية من استخدام "العينات الذهبية" (Honeypot Samples) أثناء إدارة مشروع توسيم بيانات ضخم؟
شرح: العينات الذهبية هي عينات معروفة النتيجة مسبقاً بنسبة 100%؛ إذا أخطأ فيها المراجع يتم خفض درجة موثوقيته وتجميد حسابه لحماية جودة مجموعة البيانات من التلوث.
أسئلة شائعة (FAQ)#
هل يمكن استخدام نماذج لغوية قوية (مثل GPT-4o) لتوسيم البيانات بدلاً من البشر بالكامل؟#
نعم، فيما يعرف بتقنية LLM-as-a-Judge أو التوسيم التخليقي (Synthetic Annotation)، وهي ممتازة لتوليد المسودات الأولية وتوسيم البيانات الضخمة بتكلفة منخفضة جداً، ولكن يجب أن تظل هناك عينة بشرية ضابطة لمراجعة الجودة وضمان عدم تكرار تحيزات النموذج الأساسي.
كيف نعالج مشكلة عدم توازن الفئات (Class Imbalance) في بيانات التصنيف؟#
عبر تقنيات جمع بيانات موجهة (Targeted Scraping) للحالات النادرة، أو توليد عينات تخليقية موثقة للفئات القليلة، أو تطبيق خوارزميات أخذ العينات التنافسية (Stratified Sampling) أثناء التدريب.
ما هو الفرق بين التوسيم للتصنيف (Classification) والتوسيم للضبط التوجيهي (SFT)؟#
التصنيف يضع ملصقاً أو وسماً محدداً على النص (مثل: إيجابي/سلبي)، بينما توسيم الضبط التوجيهي يتطلب صياغة ردود نموذجية كاملة ومتكاملة من قبل خبراء محتوى بشريين ليتعلم منها النموذج أسلوب الإجابة الذكية والمفصلة.